



Продолжительное время основной задачей SEO было вывести сайт в топ поисковой выдачи Google. Сейчас дела обстоят иначе. Пользователи все чаще получают ответы с помощью нейросетей, чат-ботов и AI-ассистентов.
Теперь компаниям важно работать не только над позициями в поиске, но и над видимостью сайта для ИИ-моделей. Даже страницы с хорошим ранжированием и экспертным контентом могут не появиться в ответах ChatGPT, Gemini и других AI-систем. Почему так?
Вместе с Еленой Салтыковой, тимлидом SEO Wunder Digital, раскроем, почему сайт не попадает в AI, как работают алгоритмы ИИ-ассистентов и что влияет на цитирование сайта нейросетями.
Откуда ИИ и нейросети получают информацию?
Чтобы понять, как попасть в ответы AI, нужно разобраться, откуда вообще ИИ получает данные для финального ответа.
В отличие от привычного поиска, где пользователь получает набор ссылок по степени релевантности, AI-модели самостоятельно обрабатывают информацию и создают готовый текст.
Для этого есть несколько источников:
- актуальная информация из интернета,
- данные обучения,
- подключенные базы знаний.
Каждая модель от Claude до Gemini использует свои механики выбора релевантного ответа под запрос.
Откуда модель получает знания
AI-ассистенты обучаются на больших массивах информации: открытые сайты, статьи, форумы, книги, документация, публичные источники и т.д.
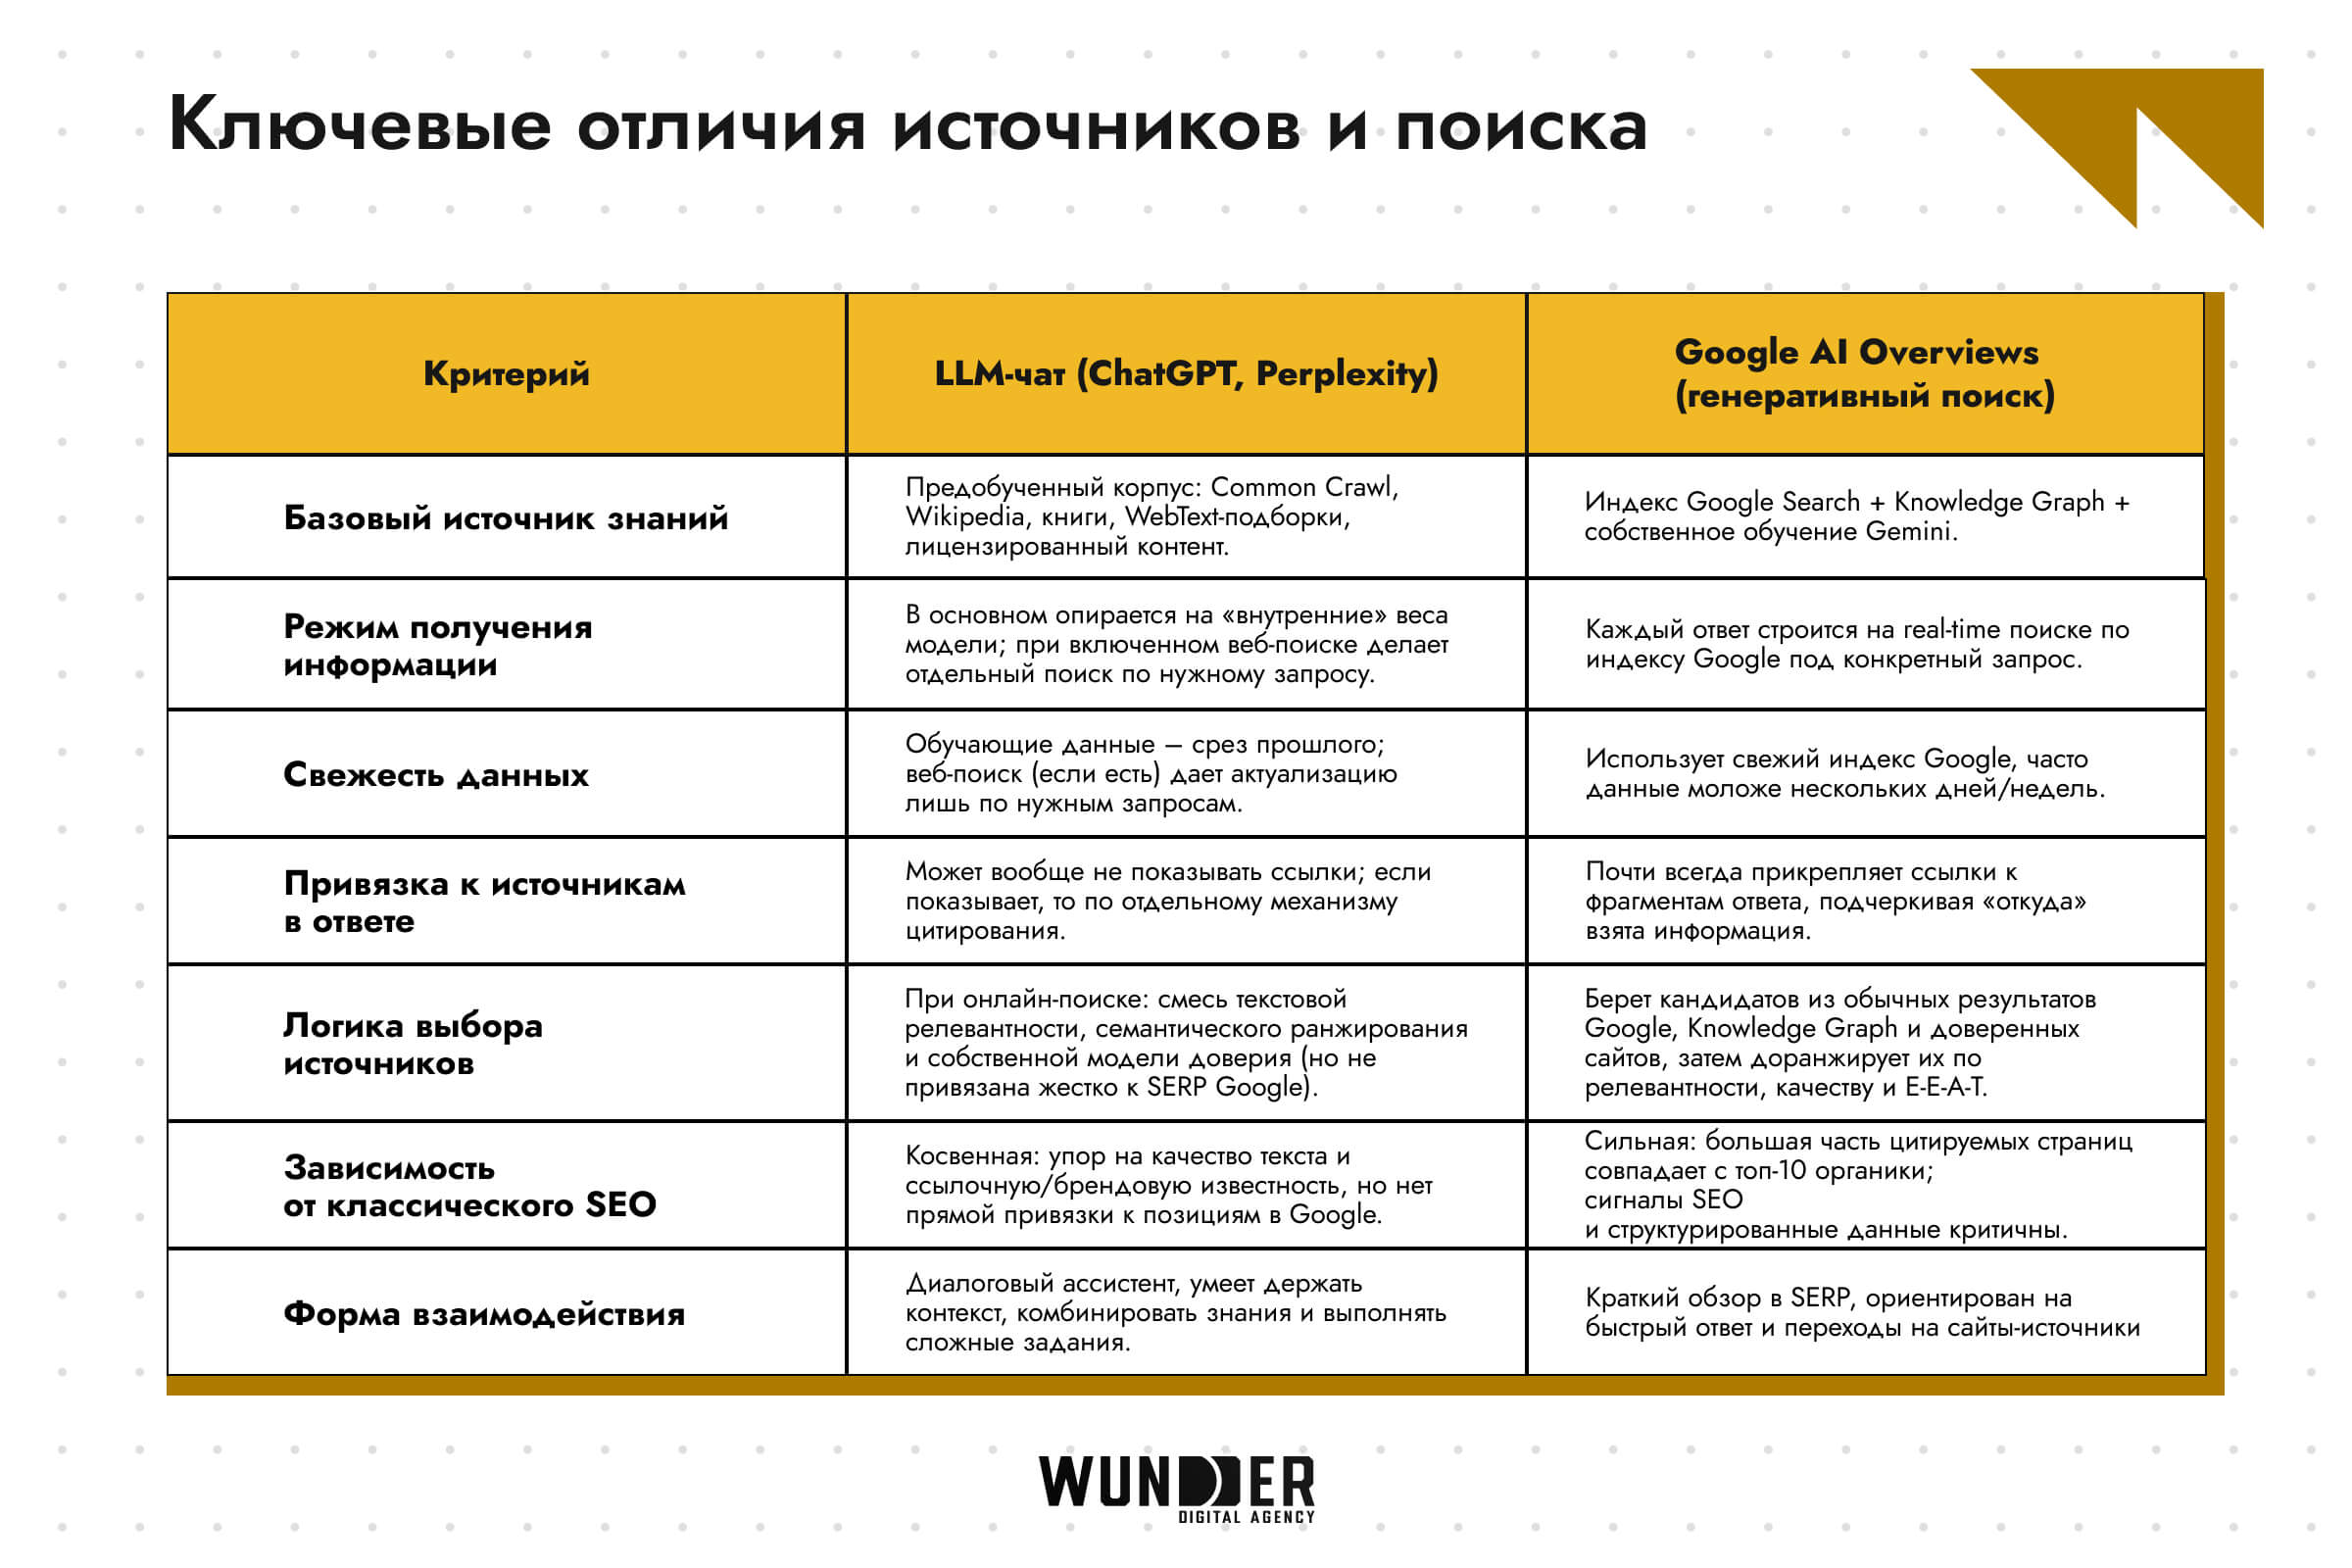
При этом нейросети не хранят определенные сайты как свою поисковую базу. Они не открывают конкретную страницу каждый раз, когда вы задаете вопрос. Модель использует те знания, которые получила во время обучения, и преобразует их в наиболее вероятный ответ.
– ChatGPT не обращается к конкретному сайту каждый раз, когда пользователь задает вопрос. Ответ формируется либо из знаний, полученных в процессе обучения, либо из результатов стороннего поиска, если такая функция включена. Поэтому вероятность попадания информации из вашего контента в ответы AI зависит от качества материала и авторитетности источника.
Чем сильнее проработан контент с точки зрения E-E-A-T (экспертиза, опыт, авторитетность и доверие), ссылочного профиля и цитируемости, тем выше шанс, что похожие материалы будут присутствовать в обучающих данных или даже станут основным источником ответа ИИ.
Поиск в интернете: как AI получает актуальную информацию
Не все ответы ИИ формируются только на базе данных из обучения. Современные AI-системы могут использовать внешний поиск для получения информации.
К примеру, поиск с использованием ИИ особенно важен для запросов, где вводные постоянно обновляются:
- новости,
- цены,
- курсы валют,
- расписания,
- актуальные события.
В таких случаях ИИ объединяет как внутренние знания, так и информацию, найденную на страницах. Отличный пример, где AI и SEO связаны напрямую: сайт должен подходить для индексации, иметь структуру, метаданные и релевантную семантику. Только так контент получит шанс на внимание ИИ.
Базы знаний
Чуть выше упомянули о данных, на которых обучаются ИИ-модели. Благодаря возможности модернизировать AI-помощников, даже обычный пользователь может самостоятельно загрузить нужные файлы, подключить корпоративные данные и создать своего ассистента для решения задач.
Часто AI-модель получает доступ к таким источникам информации:
- внутренним документам компании,
- инструкциям,
- базам знаний,
- техническим файлам,
- гайдам.
Такой механизм обучения работает как для известных программ по типу ChatGPT, так и при создании своего AI-ассистента для оптимизации работы. При этом сайты не продвигаются в топ, если их используют для обучения вашей ИИ-модели.

Как Google AI Overviews выбирает сайты для цитирования?
Google AI Overviews (ранее SGE) работает на основе поискового индекса от самого Google. Система анализирует открытые страницы, выбирает релевантную информацию и формирует ответ из фрагментов. В AI Overviews используются те же сигналы качества, что и в обычном поиске, но дополнительно учитывается фактор извлекаемости информации: насколько удобно системе взять конкретный факт со страницы.
Какие страницы попадают в AI Overviews
Приоритетно Google уделяет внимание тем страницам, которые соответствуют запросу пользователя и закрывают его интент.
Вдобавок, на вероятность попадания в AI-ответы влияют такие аспекты как:
- соответствие контента запросу пользователя,
- качество и полнота материала,
- экспертность информации,
- понятная структура страницы,
- техническая доступность сайта,
- внешние ссылки и упоминания.
При этом высокие позиции в поисковой выдаче не гарантируют цитирование сайта нейросетями.
Какие факторы повышают вероятность цитирования
В целом, AI-поиск – это комбинация классического SEO и новых требований, таких как E-E-A-T. Еще больше факторов разберем ниже.
- Релевантность и полнота ответа.
Страницы, которые точно раскрывают подтему. - E-E-A-T-сигналы.
Сильный домен, полезный контент, экспертный материал, репутация бренда и качественные внешние ссылки на сайт. - Актуальность информации.
Обновление материала по мере изменения данных. - Структура данных.
Четкие заголовки, списки, таблицы, FAQ-блоки и прямые ответы на вопросы. - Разнообразие доменов.
Несколько разных источников, а не одна ссылка.
Как Google формирует AI-ответ?
Все происходит в несколько этапов:
- Модель формирует структуру ответа на основе запроса.
- Система извлекает релевантные документы из индекса.
- Модель добавляет знания из предобучения и факты из страниц.
- К каждому фрагменту прикрепляются ссылки на 1-3 источника, которые лучше всего подтверждают тезис.
Если информация на странице плохо структурирована, AI-ассистент обратится к другому, более «удобному» материалу.

Почему нейросети не цитируют сайт
Есть несколько причин, по которым даже хорошие сайты не становятся привлекательными для AI.
- Нет коротких и прямых ответов.
Весь смысл скрыт в длинных вступлениях, поэтому модель не может извлечь факт. - Слабая структура контента.
Мало подзаголовков, списков, таблиц, FAQ-блоков. - Контент не содержит новой информации.
Если текст – это рерайт без кейсов, данных или исследований, у системы нет причин выбирать его. - Несовпадение пользовательского интента.
Пока пользователь и AI ищут полезную информацию, инструкции или чек-листы, контент сайта нацелен только на продажу товара или услуг, а не на пользу. - Слабые сигналы доверия.
Мало внешних упоминаний, неясные авторы, нет ссылок на источники, бренд не присутствует за пределами сайта.
По каким принципам AI доверяет источникам
AI-системы выбирают источники, которые выглядят опытными, экспертными, авторитетными и надежными. При этом ни одна ИИ-модель не использует E-E-A-T как единый «фактор». Он распознается через множество косвенных сигналов, например:
- Experience (опыт)
Реальные кейсы, примеры, демонстрация реального опыта работы с темой. - Expertise (экспертиза)
Точность информации, глубина объяснений, ссылки на исследования или первоисточники. - Authority (авторитет)
Упоминания бренда, внешний ссылочный профиль, репутация домена. - Trust (доверие)
Прозрачность источников и информации, корректность данных.
Более того, LLM-модели часто фокусируются на четкой структуре, наличии ссылок и легкости «извлечения» информации.
Елена Салтыкова, тимлид команды SEO Wunder Digital:
– Прокачка E-E-A-T почти всегда одновременно повышает шансы и на хороший ранкинг в Google, и на то, что AI-ассистенты будут ссылаться на ваш сайт. Плюс, для LLM-систем важен и фактор Brand Authority — насколько часто бренд упоминается в профессиональной среде: в медиа, исследованиях, обзорах и обсуждениях. Чем чаще название фигурирует в разных источниках, тем выше вероятность, что AI-модель будет воспринимать его как надежный источник.

Как AI оценивает качество контента
Нейросети не определяют автоматически части текста как «сгенерированные ИИ». Они скорее видят паттерны, которые похожи на генерации AI-моделями.
К типичным признакам слабого контента можно отнести:
- высокая предсказуемость формулировок;
- повторяемость и шаблонность конструкции;
- низкая информационная плотность;
- отсутствие фактов, цифр и источников информации;
- одинаковый ритм и тон текста.
Елена Салтыкова, тимлид команды SEO Wunder Digital:
– Если текст состоит из общих фраз и не содержит новой информации, он будет восприниматься как низкокачественный. Даже если его писал человек, а не ИИ. Важно уточнить: AI-текст сам по себе не является проблемой. Проблема – это бессодержательный, неоригинальный и бесполезный контент, который не ранжируется поисковыми системами.
Как повысить вероятность попадания сайта в ответы AI
Чтобы повысить вероятность попадания сайта в ответы AI, стоит создать такой контент, который пользователь сможет понять быстро, без лишнего напряжения. Так его с большей вероятностью обработает ИИ.
Добавим еще несколько рекомендаций:
- Отвечайте на конкретные вопросы пользователей. Закрывайте определенный интент: объясните, помогите с выбором или решите задачу.
- Структурируйте контент. Добавляйте понятные заголовки, списки, таблицы, FAQ-блоки и разметку.
- Добавляйте цифры, факты и исследования. Практический опыт и уникальные данные делают контент более ценным для любой AI-модели.
- Усиливайте E-E-A-T. Берите комментарии авторов, реальные примеры, ссылки на источники и другие подтверждения экспертизы.
- Регулярно обновляйте контент. «Свежая» информация имеет больше шансов попасть в топ и привлечь внимание ИИ-систем.
- Проверяйте техническую доступность сайта. Если статья правильно индексируется поисковыми системами, то она точно получит внимание AI-моделями.
Вывод
Хоть AI-поиск развивается, это не отменяет классического SEO, а расширяет требования к качеству сайтов. Чтобы попасть в ответы ИИ, недостаточно просто занимать высокие позиции в поисковой выдаче. Необходимо учитывать сразу несколько факторов:
- понятная структура контента
- соответствие пользовательскому запросу
- экспертность и актуальность материала
- техническая доступность сайта
- репутация сайта и цитируемость
Классическое SEO все еще остается базой для хорошего ранжирования в поиске, а подготовка материалов под AI-ответы помогает выжать максимум с продвижения сайта. Компании, которые комбинируют оба аспекта и работают как над позицией в